Shell脚本-AWK
awk可以实现精准搜索并输出,逐行处理
用法
-
非文本
前置指令 | awk 选项 条件 指令 -
文本
awk 选项 条件 指令 被处理文档
选项 -F 定义分隔符
条件 /字符串/
指令 print
输出示例:
print输出
$0全部列
**$$1......$** $n数字几就输出第几列
NR输出行号
NF输出指定行的列数,相当于输入最后一列
-F 指定分隔符
准备文件 abc.txt 内容为下:
hello the world welcome to beijing
awk '{print}' abc.txt //输出所有
awk '/the/{print}' abc.txt //输出有 the 的行
awk '{print $2}' abc.txt //输出所有行的第二列
awk '/the/{print $1}' abc.txt //输出有 the 的行的第一列
awk '{print $0}' abc.txt //输出所有列
awk '{print NR}' abc.txt //输出所有行的行号
awk '{/the/print NF}' abc.txt //输出有 the 的行有几列
awk '{print NR,NF}' abc.txt //输出所有行的行号和有几列
awk -F : '{/root/print $7}' /etc/passwd //以 : 作为分隔符输出/etc/passwd文档的第七列
AWK条件
-
/字符串/ 还可以使用正则 ~ 包含 !~ 不包含
awk -F : '$3~/3/{print}' user查找user文件中以 : 作为分隔的第三列包含3的行 -
数字文本条件
== != > >= < <=
awk -F : '$3>=1{print}' user //查找user文件中以 : 作为分隔第三列 大于等于1的行awk -F : 'NR==1{print}' user//输出user文件的第一行awk -F : 'NR>=1{print}' user//输出user文件中行数大于等于1的行awk -F : '$1=="root"{print}' user//查找user文件中以 : 作为分隔第一列的内容为root的行 -
逻辑组合
&& 并且 || 或者
awk -F : 'NR<mark>1||NR</mark>4{print}' user//输出user文件里的第一行或者第四行awk -F : '$3>=5&&$3<=10{print}' user//查找user文件中以 : 作为分隔第三行的内容 >=5,并且<=10的行 -
运算
额外任务
awk命令运行时,可以执行其他额外任务
BEGIN 任务执行 1 次,读取文档前执行
END 任务执行 1 次,读取文档后执行
awk 'BEGIN{print "开始"}{print}END{print "结束"}' user
//输出user文件内容,在读取文件前执行BEGIN任务打印"开启",在读取文档后执行END任务打印"结束"
awk 'END{print}' user 打印最后一行
示例:
如图,要达到如下效果。
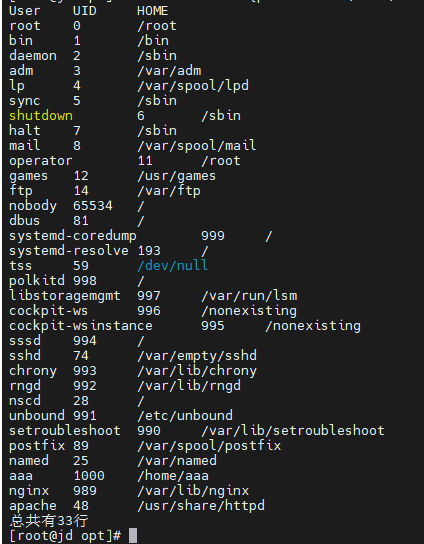
awk -F : 'BEGIN{print "User\tUID\tHOME"}{print 3"\t"$6}END{print "总共有"NR"行"}' /etc/passwd
PS:
\t 在字符串常量里使用,可以自动对齐
awk数组+for循环实现高级搜索
准备文件 s.txt 内容为下:
abc xyz abc opq xyz abc
要实现统计不同数据出现的次数
awk '{a[$1]+=1}END{for (i in a){print i" "a[i]}}' sz.txt
PS:
for(变量名 in 数组名){print 变量名} //这个格式可以查看数组的所有下标
数组默认的数值为0,所以{a[$1]+=1}可以统计不同数据出现的次数
a[$1]+=1 a[abc]+=1 a[abc]=1
a[$1]+=1 a[xyz]+=1 a[xyz]=1
a[$1]+=1 a[abc]+=1 a[abc]=2
a[$1]+=1 a[opq]+=1 a[opq]=1
a[$1]+=1 a[xyz]+=1 a[xyz]=2
a[$1]+=1 a[abc]+=1 a[abc]=3
所以统计得 abc=3 xyz=2 opq=1